Modernizing AlexNet with Batch Normalization: data pipeline and full training script
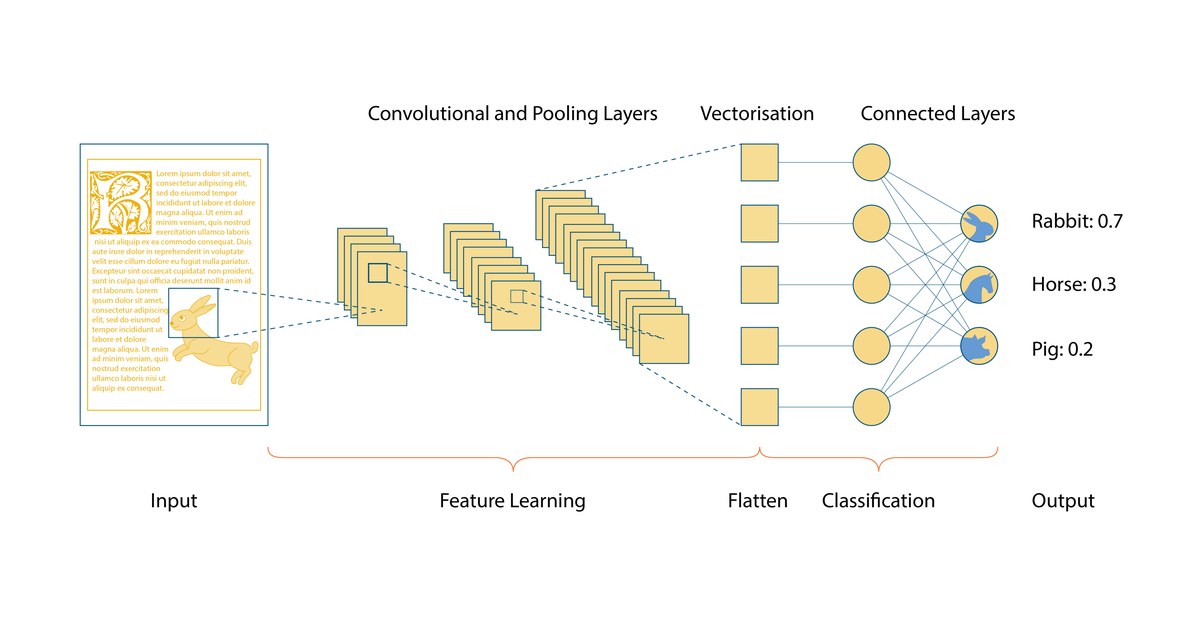
Illustrative image: A convolutional neural network: an input image passes through convolution and pooling layers to a classification output; illustrative of the deep learning approach AlexNet popularised. Image: Irisbox, CC BY 4.0, via Wikimedia Commons.
Here is a complete, production-ready PyTorch pipeline that modernizes AlexNet with Batch Normalization and configures data augmentation for both standard datasets (like CIFAR-10) and custom image folders.
1. Why Add Batch Normalization to AlexNet?
The 2012 version of AlexNet relied on Local Response Normalization (LRN) and required careful learning-rate scheduling to avoid exploding or vanishing gradients. Adding BatchNorm2d directly after each convolutional layer offers major improvements:
- Faster convergence. Normalizing layer inputs stabilizes activation distributions, allowing you to use higher learning rates without diverging.
- Reduced overfitting. BatchNorm introduces slight noise across mini-batches, acting as a natural regularizer alongside Dropout.
- Redundant bias removal. When BatchNorm2d follows Conv2d, setting bias=False in the convolutional layer saves parameters because BatchNorm's learnable shift parameter (β) replaces the convolution bias.
2. Data Augmentation & Pipeline Strategy
AlexNet expects inputs around 224 × 224 pixels. Because datasets like CIFAR-10 are tiny (32 × 32 pixels), feeding them directly into AlexNet's 11×11 stride-4 first layer will shrink the spatial dimensions to zero immediately.
- Training transforms. Resize images up to 256×256, take a random 224×224 crop, apply random horizontal flips, and jitter brightness/contrast.
- Validation/Test transforms. Resize to 256×256 and take a deterministic center 224×224 crop without randomness so evaluation metrics stay consistent.
- Channel normalization. Standardize RGB values using ImageNet's mean and standard deviation (mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]).
3. Complete Modernized PyTorch Script
This single script includes AlexNet with Batch Normalization, data loaders for both CIFAR-10 and custom folders, and a full training + validation loop.
import os
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

# ==========================================
# 1. Modernized AlexNet with BatchNorm
# ==========================================
class ModernAlexNet(nn.Module):
    def __init__(self, num_classes: int = 10, dropout: float = 0.5):
        super().__init__()

        self.features = nn.Sequential(
            # Block 1: Conv -> BatchNorm -> ReLU -> MaxPool
            nn.Conv2d(3, 64, kernel_size=11, stride=4, padding=2, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),

            # Block 2
            nn.Conv2d(64, 192, kernel_size=5, padding=2, bias=False),
            nn.BatchNorm2d(192),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),

            # Block 3
            nn.Conv2d(192, 384, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(384),
            nn.ReLU(inplace=True),

            # Block 4
            nn.Conv2d(384, 256, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True),

            # Block 5
            nn.Conv2d(256, 256, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(256),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),
        )

        self.avgpool = nn.AdaptiveAvgPool2d((6, 6))

        self.classifier = nn.Sequential(
            nn.Dropout(p=dropout),
            nn.Linear(256 * 6 * 6, 4096, bias=False),
            nn.BatchNorm1d(4096),
            nn.ReLU(inplace=True),

            nn.Dropout(p=dropout),
            nn.Linear(4096, 4096, bias=False),
            nn.BatchNorm1d(4096),
            nn.ReLU(inplace=True),

            nn.Linear(4096, num_classes),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = self.avgpool(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x


# ==========================================
# 2. Data Pipeline & Augmentations
# ==========================================
def get_dataloaders(dataset_type: str = "cifar10", data_dir: str = "./data", batch_size: int = 64):
    # Standard ImageNet normalization stats
    norm_mean = [0.485, 0.456, 0.406]
    norm_std = [0.229, 0.224, 0.225]

    train_transforms = transforms.Compose([
        transforms.Resize((256, 256)),
        transforms.RandomCrop((224, 224)),
        transforms.RandomHorizontalFlip(p=0.5),
        transforms.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
        transforms.ToTensor(),
        transforms.Normalize(mean=norm_mean, std=norm_std),
    ])

    val_transforms = transforms.Compose([
        transforms.Resize((256, 256)),
        transforms.CenterCrop((224, 224)),
        transforms.ToTensor(),
        transforms.Normalize(mean=norm_mean, std=norm_std),
    ])

    if dataset_type == "cifar10":
        train_dataset = datasets.CIFAR10(root=data_dir, train=True, download=True, transform=train_transforms)
        val_dataset = datasets.CIFAR10(root=data_dir, train=False, download=True, transform=val_transforms)
        num_classes = 10

    elif dataset_type == "folder":
        # Expects structure: data_dir/train/class_x/img.jpg & data_dir/val/class_x/img.jpg
        train_dataset = datasets.ImageFolder(root=os.path.join(data_dir, "train"), transform=train_transforms)
        val_dataset = datasets.ImageFolder(root=os.path.join(data_dir, "val"), transform=val_transforms)
        num_classes = len(train_dataset.classes)
    else:
        raise ValueError("dataset_type must be 'cifar10' or 'folder'")

    train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True, num_workers=4, pin_memory=True)
    val_loader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False, num_workers=4, pin_memory=True)

    return train_loader, val_loader, num_classes


# ==========================================
# 3. Training & Evaluation Engine
# ==========================================
def train_one_epoch(model, loader, criterion, optimizer, device):
    model.train()
    running_loss, correct, total = 0.0, 0, 0

    for images, labels in loader:
        images, labels = images.to(device, non_blocking=True), labels.to(device, non_blocking=True)

        optimizer.zero_grad()
        outputs = model(images)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        running_loss += loss.item() * images.size(0)
        _, predicted = outputs.max(1)
        total += labels.size(0)
        correct += predicted.eq(labels).sum().item()

    return running_loss / total, 100.0 * correct / total


@torch.no_grad()
def evaluate(model, loader, criterion, device):
    model.eval()
    running_loss, correct, total = 0.0, 0, 0

    for images, labels in loader:
        images, labels = images.to(device, non_blocking=True), labels.to(device, non_blocking=True)
        outputs = model(images)
        loss = criterion(outputs, labels)

        running_loss += loss.item() * images.size(0)
        _, predicted = outputs.max(1)
        total += labels.size(0)
        correct += predicted.eq(labels).sum().item()

    return running_loss / total, 100.0 * correct / total


if __name__ == "__main__":
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

    # Switch dataset_type="folder" and point data_dir to your custom dataset path
    train_loader, val_loader, num_classes = get_dataloaders(
        dataset_type="cifar10",
        data_dir="./data",
        batch_size=64
    )

    model = ModernAlexNet(num_classes=num_classes).to(device)
    criterion = nn.CrossEntropyLoss()
    optimizer = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-2)
    scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=10)

    epochs = 10
    for epoch in range(1, epochs + 1):
        train_loss, train_acc = train_one_epoch(model, train_loader, criterion, optimizer, device)
        val_loss, val_acc = evaluate(model, val_loader, criterion, device)
        scheduler.step()

        print(f"Epoch [{epoch:02d}/{epochs}] "
              f"Train Loss: {train_loss:.4f} | Train Acc: {train_acc:.2f}% | "
              f"Val Loss: {val_loss:.4f} | Val Acc: {val_acc:.2f}%")
4. Practical Tips for Running Custom Datasets
- Folder organization. If you switch dataset_type="folder", structure your files with one subfolder per class:
my_dataset/
├── train/
│   ├── cats/
│   └── dogs/
└── val/
    ├── cats/
└── dogs/- Batch size rule with BatchNorm1d. Because the classifier includes nn.BatchNorm1d(4096), ensure your training batch size never drops to 1 on the final leftover batch of an epoch. If your dataset size leaves a remainder of 1 image, pass drop_last=True inside train_loader.
- Small datasets (< 5,000 images). Training 57+ million parameters from scratch on a small custom dataset can still overfit even with BatchNorm and Dropout. If validation accuracy stalls early, consider freezing self.features on a pre-trained model or shrinking the dense layers from 4096 down to 1024.